Сбор семантического ядра начинается не с выгрузки миллиона ключевых фраз, а с перечня бизнес-объектов, услуг, типов аудитории, регионов и пользовательских задач. Без этого даже аккуратно очищенная база запросов может привести к неправильной структуре: запросы будут группироваться по словам, а не по типу страницы, который действительно ищут люди.
Этап 1. Описать бизнес и существующие посадочные
Составьте матрицу товарных групп, услуг, задач, типов клиентов, географии и имеющихся разделов. Для каждой строки отметьте прибыльность, сезонность, ограничения ассортимента и самостоятельность интента. Это позволит отличить запрос, которому нужна новая посадочная, от вопроса, который лучше раскрыть на существующей странице.
Не начинайте с фиксации тысячи узких кластеров по отдельным словоформам. Сначала проверьте, что у бизнеса есть предложение для каждого направления и целевая страница действительно может конвертировать пользователя.
Этап 2. Собрать запросы из разных источников
Используйте маркерные фразы, Wordstat, поисковые подсказки, собственную GSC, Яндекс.Вебмастер, Яндекс.Метрику при наличии данных, а также конкурентную семантику из Keys.so и Букварикса. Эти источники имеют разную природу. Показ, клик, визит, частотность Wordstat и доменная позиция не являются одной метрикой.
| Источник | Что даёт | Чего не даёт |
|---|---|---|
| Wordstat | Формулировки и оценку спроса | Готовый список посадочных URL |
| Search Console | Клики, показы, CTR, средние позиции Google | Полную независимую SERP-выдачу |
| Яндекс.Вебмастер | Запросы собственного сайта и поисковые показатели | Все поисковые запросы рынка |
| Букварикс | Расширение и сравнение семантики доменов | Полную query→URL→TOP-10 выдачу |
| Keys.so | Исторические данные видимости и конкурентные отчёты | Гарантию полного TOP на каждый запрос |
| Съём SERP | URL и позиции по фиксированным параметрам | Долгосрочный спрос сам по себе |
Фиксируйте source, дату, базу, регион, поисковую систему, период и тип показателя при каждом импорте. Без этого кластеры трудно пересчитать и невозможно корректно сравнить сезонные результаты.
Этап 3. Нормализовать и очистить базу
Удаляйте технические дубли, нецелевые географии, мусорные формулировки и запросы, не соответствующие предложению. Сохраняйте сырую выгрузку отдельно от очищенного набора. Для брендов, артикулов, профессионального жаргона и иностранных названий не применяйте бездумное исправление орфографии: можно разрушить важные сущности.
Частотность ноль не всегда означает отсутствие спроса: это может быть недостаток данных, редкий длинный хвост или другой регион. Не уничтожайте низкочастотные запросы без проверки бизнес-релевантности.
Этап 4. Классифицировать интенты
Определяйте информационный, коммерческий, транзакционный, навигационный и локальный характер запроса. Учитывайте смешанные случаи: «цена SEO-аудита» требует цен и коммерческих условий, но может включать объяснение факторов стоимости. Методика с примером — в статье информационные и коммерческие запросы.
Не превращайте каждый тип интента в отдельный URL: сначала проверьте структуру органической выдачи и сходство ранжирующихся страниц.
Этап 5. Кластеризация на основании SERP
Для сопоставимых запросов снимите TOP в одной поисковой системе, регионе, типе устройства и близком периоде. Сравнивайте URL-лидеров и перекрытие результатов, а не только косинусное сходство слов. Полученную группировку проверяйте вручную на смешанных намерениях, каннибализации и необычных SERP-форматах.
Для программы SEO Semantic Lab важна последовательность: «Фразы → SERP+Позиции → Кластеризация → Стратегия → Структура». Простое импортирование органических фраз отдельного домена из Keys.so или Букварикса не заменяет полноценный TOP. Практический разбор кластеризации поможет проверить результат на конкретных запросах.
Этап 6. Кластер → существующий URL или новая посадочная
Для каждой группы укажите намерение, URL-лидер, свою текущую страницу, предлагаемую посадочную и действие: улучшить, создать, объединить, исключить или перепроверить. В таблице отметьте источники доказательств, частотность, текущие позиции, конверсии и пример конкурента. Приоритет не равен одной сумме частотностей: на него влияют экономика проекта, сложность реализации и соответствие ассортимента.
Пример: запросы «настройка Яндекс.Метрики», «подключить цели Метрики» и «внести данные Метрики в SEO-программу» могут требовать разных ответов. Общую инструкцию не следует бесконтрольно размножать на микространицы, пока не проверено различие выдачи и интента.
Этап 7. Работа с сущностями, N-граммами и конкурентами
Из конкурирующих страниц извлекайте полезные тематические блоки, сущности и отношения: «поисковый запрос → принадлежит → кластеру», «кластер → назначен → URL», «страница → отвечает → интенту». Bigram/trigram-частотность полезна как диагностическая характеристика корпуса, но сама по себе не является инструкцией повторять сочетание определённое число раз.
Для проверки Content Effort оцените охват сценариев, качество примеров, источники, ограничения, интерактивные действия, таблицы и наличие самостоятельных выводов. Переспамить текст терминологией проще, чем сделать рабочий шаблон кластеризации.
Редакционный бриф по каждому кластеру может включать наблюдения из трёх-пяти страниц с совпадающим типом выдачи: какие вопросы они закрывают, каких данных нет у собственной страницы, какие сущности являются предметными, а какие — случайными. Не нужно добавлять на страницу весь найденный словарь: важна структура ответа. При анализе конкурента отдельно отличайте утверждения, подтверждённые первоисточником, от мнений автора и устаревших скриншотов. Если SERP менялся, дату источника указывайте прямо в исследовательской таблице.
Проверку завершайте не только техническим чек-листом, но и редакционным: способен ли пользователь решить задачу после чтения и не возникает ли у него необходимости искать отдельную инструкцию для каждого базового шага. Это практический критерий глубины, который лучше служит задаче, чем произвольное число вхождений.
Этап 8. Документация и контроль качества
Готовая таблица должна позволять исполнителю быстро ответить: где запрос будет обслуживаться, почему выбран именно этот URL, какие данные это подтверждают, какие новые блоки нужны и как измерить эффект. Храните версию семантики, дату SERP и отметки ручного контроля.
Проверка после внедрения — не только позиции. Смотрите реальные показы, CTR, входы, цели и обращения по обновлённым URL, контролируя разные источники и периоды. Через некоторое время можно пересчитать кластеры, но делать это при каждом незначительном изменении данных без контроля версий опасно.
Пример таблицы назначения кластеров
| Кластер | Интент | URL | Действие | Риск |
|---|---|---|---|---|
| «SEO-аудит цена» | Коммерческий | /uslugi/seo-audit |
Дополнить стоимостью и примерами | Каннибализация с консультацией |
| «как проверить canonical» | Информационный | /shkola-seo/.../canonical |
Создать или усилить практикум | Ошибочные HTTP/JS предположения |
| «SEO Semantic Lab Букварикс» | Продуктовый how-to | /seo-semantic-lab/spravochnik/bukvarix-api-seo-semantic-lab |
Уточнить шаги интерфейса | Нельзя обещать полный SERP из доменного API |
Пути в этом примере демонстрационные: при работе с реальным сайтом необходимо привязать решения к существующим опубликованным URL и текущей стратегии. Такой лист полезнее строки «группа = 37 ключей»: он показывает, что именно нужно сделать и где проверять эффект.
Как согласовать семантику с разработчиком и редактором
Разработчику передавайте URL-карту, правила генерации адресов, требования к статусам, canonical, Sitemap, региональности и фасетам. Редактору — пользовательский вопрос, целевую роль страницы, обязательные факты и иллюстрации. Аналитику — текущие показатели, период и способ отслеживания цели. Разделение обязанностей предотвращает ситуацию, когда после кластеризации структура оказывается технически невозможной или страницы не получают нужные данные.
При внедрении на MODX, WordPress или другой CMS сохраняйте старые адреса и индексационные настройки до подтверждения новой архитектуры. Кластеризация — проектное решение, не причина массово менять robots/canonical на живом сайте.
Полезные инструкции
Карта посадочных страниц, интеграция Keys.so, Букварикс API, источники данных.
Архивные иллюстрации и первоначальные наблюдения
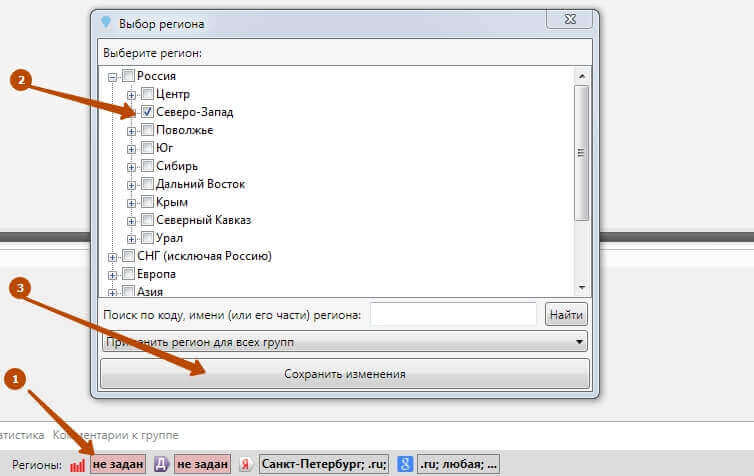
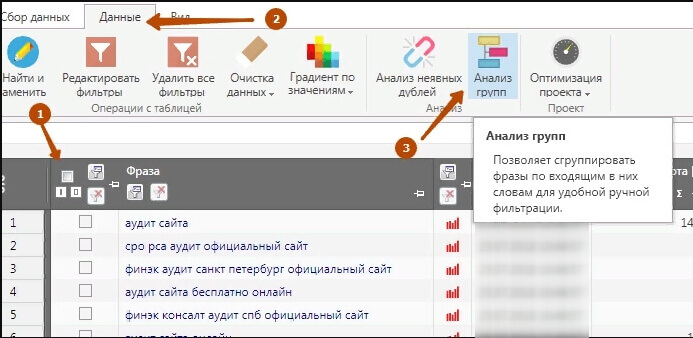
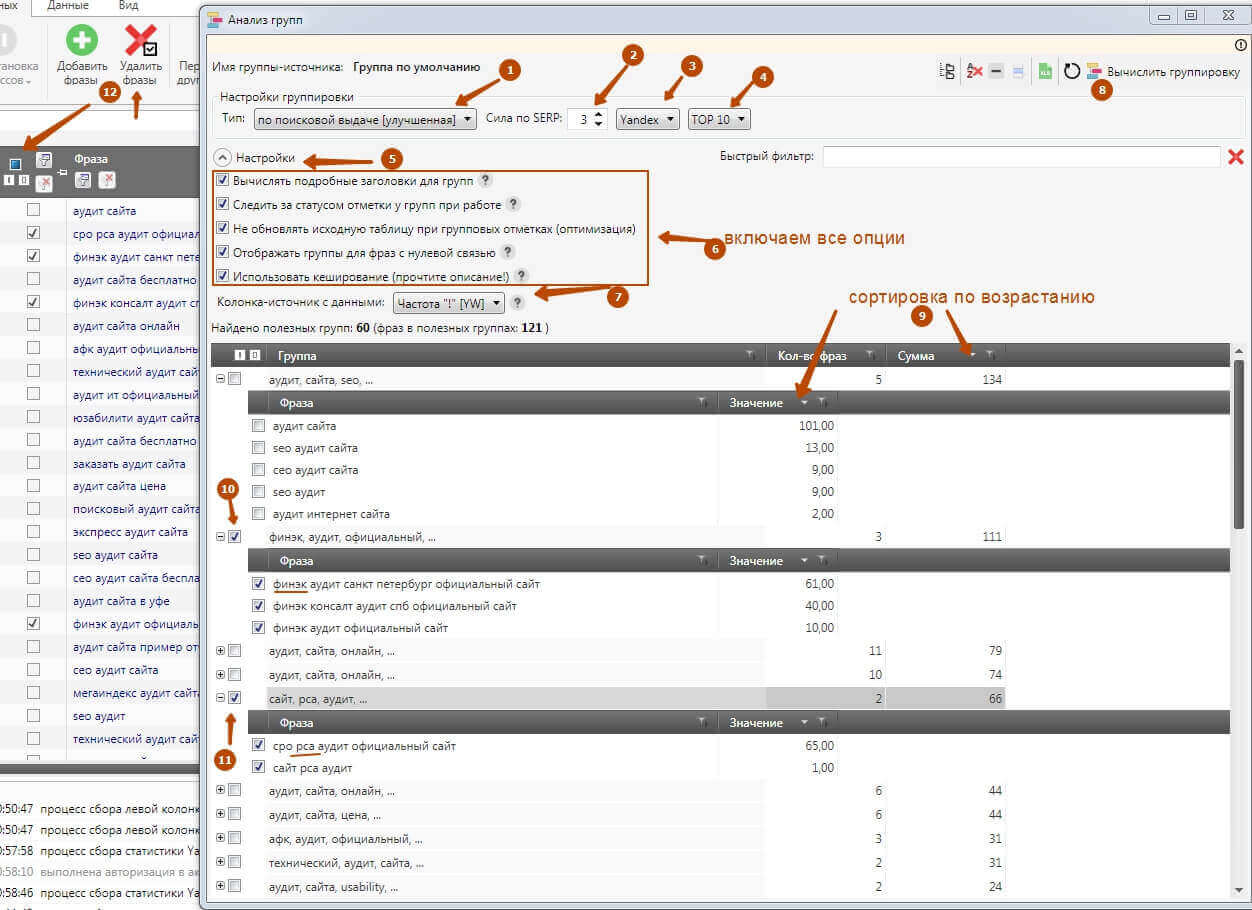
Это материалы из первоначальной версии статьи. Скриншоты и старые интерфейсы сохранены как часть истории публикации; они не доказывают актуальность показанных функций и результатов.
Показать архивные изображения (3)
Следующие страницы вас также могут заинтересовать:
- Робототехника
- SEO-продвижение образовательного сайта: 7 лет — от старого HTML до AI Search
- Паллетирование: что это такое, технологии, оборудование и роботизация
- Промышленные роботы: что это, виды, устройство и применение
- Машинное зрение в робототехнике: что это, как работает и где применяется
Обновлено: 11.10.2026