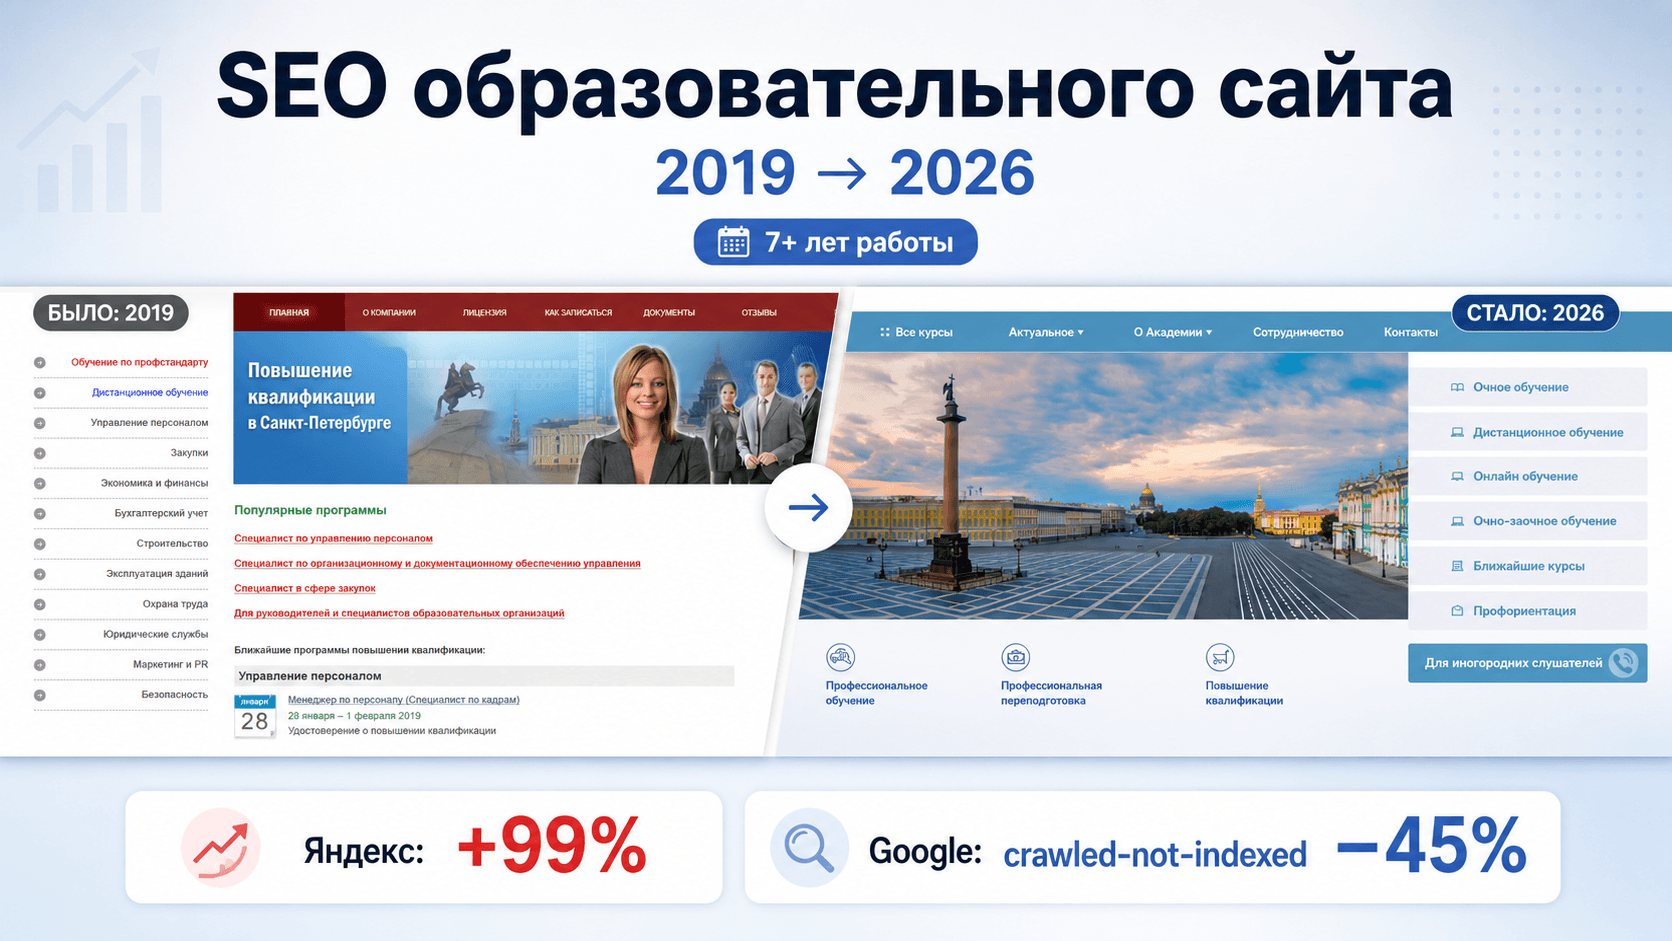
Семь лет SEO одного образовательного проекта: от старого HTML-сайта до системной семантики, продуктовой аналитики и AI Search
Это не история про одну удачную оптимизацию и не кейс формата «поменяли Title — получили рост». Работа началась в мае 2019 года со старого сайта, который нужно было оптимизировать в том виде, в котором он существовал. Затем я участвовал в разработке новой версии, давал SEO-рекомендации по будущему проекту, но часть решений команда реализовала без полноценного учёта поисковой архитектуры. После запуска пришлось годами разбирать накопленный технический долг, контролировать внедрения нескольких программистов и верстальщиков, пересобирать семантику, развивать контент, категории и коммерческие страницы, бороться с роботным трафиком и постепенно переводить SEO из режима «исправить после публикации» в режим проектирования до разработки.
Крупный сайт дополнительного профессионального образования с длинной историей разработки
Когда я пришёл, сайт уже существовал: первой задачей была SEO-оптимизация старой HTML-версии
Важный нюанс этого кейса: я не пришёл на пустой домен и не начинал с разработки нового проекта. Первым сайтом, который мне дали в работу, был уже существующий образовательный сайт старого поколения.
Он имел историческую структуру, старые шаблоны, каталог с числовыми URL, большое боковое меню, ручную верстку и довольно жёсткие ограничения по тому, как быстро можно было менять архитектуру.
Поэтому первый этап был классическим SEO существующего legacy-сайта: разбирать, что уже индексируется, какие направления дают спрос, какие страницы можно усиливать без полной перестройки, где нужны метатеги, тексты, перелинковка, корректировка категорий и работа с поисковой видимостью.

Что делалось на старой версии
- анализ существующих категорий и страниц под реальный поисковый спрос;
- работа с Title, Description, H1 и текстовой релевантностью;
- оптимизация коммерческих и тематических страниц;
- внутренняя перелинковка;
- работа с индексированием и поисковой аналитикой;
- поиск новых тематик, которые можно было развивать без полной смены платформы;
- подготовка требований к будущей версии сайта с учётом SEO.
Я участвовал в разработке нового сайта, но итоговая архитектура получилась не полностью SEO-first
Следующий этап — создание новой версии проекта. Я участвовал в обсуждении и давал SEO-рекомендации: как строить структуру, какие типы страниц нужны, как работать с категориями, индексированием, URL и посадочными страницами. Часть идей была принята и реализована.
Но далеко не все решения прошли через SEO-проектирование. Значительную часть структуры команда сформировала самостоятельно, исходя из продуктовой и внутренней логики каталога.
В результате новый сайт оказался современнее визуально и удобнее как система управления, но некоторые архитектурные решения пришлось исправлять уже после запуска.
SEO заканчивается не на ТЗ: часть исправлений приходилось внедрять и перепроверять несколько раз
На длинном проекте менялись программисты и верстальщики. Часть рекомендаций внедрялась хорошо, часть — частично, часть создавала новые побочные эффекты.
Поэтому реальный рабочий цикл выглядел не как «нашёл ошибку → написал ТЗ → готово», а как многократная проверка production после каждого внедрения.
Коммерческий каталог отражал внутреннюю логику программ, но не всегда логику SERP и поисковых интентов. В результате близкие запросы могли быть распределены по нескольким слабым страницам, а сильный кластер — не иметь полноценной посадочной.
На одном из больших технических этапов были обнаружены десятки тысяч вариантов URL с GET-параметрами: фильтры, служебные параметры, tracking-параметры, preview и другие комбинации. Это увеличивало пространство обхода и риск дублей.
После миграций и многолетних изменений на сайте накапливались ссылки через промежуточные 301, старые URL и 404. Это ухудшало качество внутренней архитектуры и усложняло обход.
На проекте были периоды, когда SEO-плагин, шаблоны, noindex, canonical или отдельные технические элементы работали не так, как ожидалось. Исправление в одном шаблоне не гарантировало, что проблема не появится снова после следующей доработки.
Большой технический аудит показал, насколько важен повторный контроль после исправлений
В январе 2022 года был проведён полноценный технический аудит с использованием Netpeak Spider, Google Search Console, Google Analytics и Яндекс.Метрики.
Это уже не реконструкция по памяти: сохранились исходные выгрузки и повторная проверка после внедрений.
Скорость: проблема, которую удалось измерить «до» и «после»
Среднее время ответа по этой выборке снизилось примерно с 2,94 до 0,66 секунды.
Это хороший пример того, зачем нужен повторный аудит: первоначальный отчёт сам по себе ничего не доказывает, а контрольный срез показывает, что технические изменения действительно дали эффект.

Цепочки редиректов
В аудите было найдено 589 URL с цепочками перенаправлений:
- 477 цепочек из двух редиректов;
- 80 цепочек из трёх;
- 28 цепочек из четырёх;
- 4 цепочки из пяти.

Что ещё показал аудит
- 20 062 сочетания URL × поисковый запрос в выгрузке Google Search Console;
- 13 531 уникальный поисковый запрос;
- около 468 URL, которые уже имели поисковую видимость Google;
- 243 страницы имели показы, но ноль кликов — суммарно около 90,5 тыс. показов;
- 29 страниц из этого массива имели более 1 000 показов каждая;
- 11 275 случаев отсутствующего alt, но значительная часть приходилась на повторяющиеся шаблонные изображения;
- проверялись крупные изображения, внутренние ссылки, орфография, поведенческие метрики и качество индексации.
Следующий этап — перестать оптимизировать страницы по одной и начать проектировать спрос кластерами
После технической части работа всё сильнее смещалась в сторону больших массивов семантики.
Для образовательного сайта это особенно важно: один и тот же пользовательский спрос может быть закрыт карточкой курса, категорией, статьёй, страницей профессии, FAQ или несколькими страницами, которые начинают конкурировать друг с другом.
Что анализировалось
- поисковые запросы и их частотность;
- пересечение URL в выдаче;
- домены и страницы-лидеры по тематике;
- тип документа, который поисковик предпочитает по кластеру;
- структура H1–H6 у сильных конкурентов;
- текстовые сущности и тематические термины;
- внутренняя конкуренция собственных URL;
- потенциал коммерческой страницы относительно информационной.
К концу 2023 года сохранилось новое крупное семантическое ядро на 51 328 фраз.
Отдельно анализировалась большая история запросов Google: 25 922 уникальных поисковых запроса, 22 766 кликов и 1 806 657 показов в соответствующей накопленной выгрузке.

Раздел с профессиями превратился из единичной точки входа в десятки поисковых посадочных
Одним из заметных экспериментов стало масштабирование информационно-коммерческого слоя по рабочим специальностям и профессиям.
Для страниц готовились детальные ТЗ на основе семантики и анализа сильных конкурентов: Title, H1, структура H2–H6, тематические термины, объём, ссылки и логика текста.
В сопоставимом срезе раздел, где ранее поисковый трафик фактически концентрировался на единичной странице, получил десятки самостоятельных поисковых точек входа.
В том же сравнении количество посетителей блога выросло примерно на 36%, а показатель дочитывания в отчёте увеличился примерно с 28,75% до 47,95%.

ChatGPT начали использовать в SEO-процессе ещё в 2023 году — не вместо семантики, а поверх неё
Практически сразу после появления доступных генеративных моделей мы начали экспериментировать с их применением в контентном производстве.
Но схема была не «дай нейросети тему и опубликуй тысячу текстов». Входными данными служили уже подготовленные SEO-материалы.
Что отдавалось нейросети
- утверждённый поисковый интент;
- подготовленная структура страницы;
- частотные и тематические слова;
- ограничения по Title, H1 и Description;
- конкретная задача отдельного блока;
- требование не смешивать информационный и коммерческий интент.
Что оставалось на человеке
- выбор целевого кластера;
- решение, нужна ли отдельная страница;
- оценка конкурентов;
- контроль фактов;
- редактура и логика;
- решение о перелинковке и коммерческом маршруте пользователя.
Даже порядок курсов в категории пришлось связывать с реальным пользовательским спросом
В начале 2023 года возникла практическая проблема: курсы внутри направления выводились по дате публикации.
Новая программа автоматически оказывалась наверху, а самые востребованные и продаваемые могли уходить вниз длинного списка.
Для категорий с большим количеством программ это было не только UX-проблемой, но и коммерческой: важные страницы получали меньше внутренних переходов и хуже использовали вес раздела.
В 2023 году проект стал полигоном для большого антибот-эксперимента
На сайте наблюдались расхождения между кликами поисковых систем и визитами аналитики, подозрительная автоматизированная активность и высокая нагрузка.
С 22 августа 2023 года проводился отдельный эксперимент с фильтрацией ботов и оценкой качества трафика.
Глубина просмотра в сравниваемых периодах выросла примерно с 1,77 до 1,94.
В тех же периодах росли и поисковые клики: Google Search Console — с 6 126 до 9 588, Яндекс — с 1 772 до 2 154.

После масштабирования главным риском стал возвращающийся технический долг
Большой сайт не остаётся неизменным. Появляются новые курсы, категории, сотрудники, плагины, шаблоны, документы и формы.
Поэтому часть работы 2024–2025 годов — это не «запустить ещё один кластер», а постоянно не давать проекту снова накопить критические ошибки.
Что регулярно контролировалось
- 403 и другие ошибки доступности;
- 5xx и проблемы обхода sitemap;
- noindex;
- canonical;
- редиректы;
- 404;
- индексирование Google и Яндекса;
- работа SEO-плагинов и шаблонных метатегов;
- внутренние ссылки;
- новые страницы, созданные редакторами без предварительного SEO-анализа.
В 2025 году пришлось отдельно разбираться с ситуацией, когда SEO-настройки сайта могли приводить к некорректному noindex и потере метатегов.
Это потребовало смены или перенастройки SEO-плагина, проверки шаблонов и повторного обхода.
От отдельных SEO-текстов — к связкам «статья → тематическая категория → коммерческий курс»
По мере роста сайта стало очевидно, что просто публиковать новые статьи недостаточно.
Информационный спрос может давать огромный охват, но пользователь не обязательно понимает, куда перейти дальше и какой курс решает его задачу.
Поэтому в 2025–2026 годах я всё чаще проектировал не одну страницу, а связку документов: информационная статья раскрывает вопрос, тематическая категория собирает коммерческое предложение, а конкретная программа закрывает более узкий интент.
Такой подход применялся, в частности, в темах профориентации, информационной безопасности, делопроизводства, закупок, технических программ и других направлений.
Ключевой вывод большого анализа: поисковый трафик мог расти, а заявки — снижаться
В марте 2026 года я отдельно свёл поисковый трафик, заявки и данные по фактически выданным документам за большой исторический период.
Это был принципиально другой уровень анализа: не «какие позиции выросли», а «какая часть поискового спроса вообще связана с бизнес-результатом».
Почему так могло происходить
За 2024–2025 годы в анализируемой выгрузке было 79 584 поисковых визита.
Около 65,2% приходилось на информационный слой, тогда как коммерческие страницы формировали существенно меньшую долю — около 25,3%.
Три крупнейшие информационные страницы давали около 56,2% всего поискового трафика в рассматриваемом наборе.
Это означает, что общий график посещаемости мог выглядеть хорошо, даже если коммерческие кластеры чувствовали себя значительно хуже.
Что изменилось в подходе после этого анализа
- макро- и микроконверсии нужно считать отдельно;
- «любая цель» Метрики не должна быть главным бизнес-KPI;
- трафик нужно разрезать по типу страницы и направлению;
- сильные информационные кластеры нужно монетизировать через внутренние маршруты;
- новые образовательные продукты логичнее создавать там, где спрос подтверждён семантикой и реальной отдачей;
- для документов и продаж нужно учитывать лаг 1–4 месяца, а не только результат текущего месяца.
Семантика стала использоваться не только для продвижения существующих курсов, но и для выбора новых направлений
Когда есть несколько лет поисковой статистики, можно анализировать не только страницы, но и сам образовательный ассортимент.
В 2026 году отдельный анализ показал, что технические и инженерные направления уже имеют подтверждённый коммерческий спрос.
В качестве приоритетных ростовых треков рассматривались закупки, АСУ ТП и смежные инженерные программы.
При этом крупные информационные темы делопроизводства, архива и секретариата требовали не столько «найти ещё запросы», сколько лучше переводить существующий интерес в коммерческие переходы.
| Направление | Средний коммерческий спрос в месяц по анализу 2024–2025 | Наиболее сильные окна | Практический вывод |
|---|---|---|---|
| Закупки | 200,2 | февраль–май, особенно апрель–май | усиливать заранее, начиная с января |
| Медицина | 77,7 | январь, март, август | сильное коммерческое направление, но выраженная сезонность |
| АСУ ТП / инженерия | 59,2 | январь, апрель, июль | логичный отдельный продуктовый и SEO-трек |
| Автотранспорт / БДД | 59,4 | январь, март, май | не оценивать по одному месяцу, учитывать сезонность |
| Бухгалтерия / финансы | 56,2 | апрель, июль, сентябрь | точечно усиливать сильные коммерческие страницы |
| Делопроизводство / архив / секретариат | 27,7 | январь–март | главный резерв — монетизация большого информационного охвата |
Яндекс: органический трафик вырос примерно вдвое даже после исключения визитов, классифицированных Метрикой как роботы
Для периода 1 сентября 2025 — 31 августа 2026 и предыдущего сопоставимого года органический трафик Яндекса вырос с 18 639 до 41 253 визитов.
Это +121,3%.
Но на сайте заметно выросла и роботность. Поэтому для более консервативной оценки я отдельно вычел визиты, которые сама Яндекс.Метрика классифицировала как роботов.

Рост был не только в объёме, но и в ширине семантики
Один большой информационный кластер действительно стал сильным драйвером: он вырос примерно с 45 до 5 685 визитов и давал заметную долю известного поискового трафика.
Поэтому я отдельно пересчитал результат без него.
После полного исключения этого кластера остальные известные запросы всё равно выросли примерно с 11 930 до 19 543 визитов, то есть примерно на 63,8%.
Разные направления вели себя по-разному
| Кластер | Динамика известного поискового трафика | Интерпретация |
|---|---|---|
| Делопроизводство / архив | примерно +50% | устойчивый широкий спрос и рост long tail |
| Закупки | примерно +47% | сильный коммерческий кластер |
| Профориентация | 1 → 27 визитов | небольшая база, но новая семантика начала работать |
| Информационная безопасность / ПД | примерно −49% | новые страницы получили видимость, но широкий кластер год к году просел |
| Автотранспорт / БДД | примерно −64% | пример того, что не все направления растут вместе с сайтом |
| Наставничество | примерно −25% | часть старого информационного спроса снизилась |
Классический Google просел — одновременно техническая индексация стала заметно чище
Если смотреть не только на сильный Яндекс, а на картину целиком, Google в последнем большом периоде выглядел существенно хуже.
По Метрике органические визиты Google снизились примерно с 59 678 до 38 831, то есть на 34,9%.
Если дополнительно исключить визиты, классифицированные Метрикой как роботы, консервативное сравнение получается ещё жёстче: примерно 59 512 → 34 686, то есть около −41,7%.

При этом техническое состояние индекса Google улучшилось
Также выросло количество URL в категории редиректов: примерно со 104 до 130.
Discovered, currently not indexed почти не изменился: около 250 → 245.
То есть нельзя сказать: «в Google всё исправили».
Правильнее: один крупный пласт индексации удалось очистить, но поисковый спрос и часть технических проблем остались.
При этом техническое состояние индекса Google по одной из важных причин заметно улучшилось: количество URL в статусе «Страница просканирована, но пока не проиндексирована» снизилось примерно с 237 до 131, то есть примерно на 45%.

Отдельные новые и доработанные страницы всё же росли
- страница профориентации: клики 33 → 43, показы 802 → 1 979;
- раздел делопроизводства: клики 201 → 263, средняя позиция улучшилась примерно 32,4 → 18,2;
- новая коммерческая страница по информационной безопасности получила 513 показов и 18 кликов;
- новая тематическая категория получила первые 191 показ и 4 клика;
- новая экспертная статья получила около 140 показов и 8 кликов, тогда как в предыдущем периоде кликов не было;
- одна из доработанных технических программ улучшила среднюю позицию примерно 27,5 → 18,7, но клики одновременно снизились с 15 до 6 — пример отдельной проблемы CTR.
Достижения целей полезны для диагностики, но я не называю их лидами или продажами
В текущем годовом срезе Яндекса зафиксировано около 41 253 визитов и 5 407 достижений целей.
В Google — около 38 831 визита и 6 437 достижений целей.
Взвешенная конверсия «по любой цели» составляла примерно 9,9% для Яндекса и 13,8% для Google.
Но одна сессия может вызвать несколько целей, а часть целей является микроконверсиями. Поэтому эти значения нельзя автоматически переводить в число заявок или оплаченных заказов.
К 2026 году проект получил заметную видимость не только в классическом поиске, но и в AI-ответах
В мае 2026 года на сайте был внедрён отдельный пакет для AI/LLM discovery: llms.txt, расширенная версия, AI-policy, AI-sitemap, дополнительные privacy/security-файлы и изменения robots.txt.
При этом я не утверждаю, что именно наличие llms.txt вызвало AI-видимость.
Параллельно работали контент, внутренняя структура, сущности, schema и общий авторитет страниц.
Корректный вывод: сайт уже начал заметно присутствовать в генеративных интерфейсах, а AI-инфраструктура стала дополнительным техническим слоем.


Основной AI-охват формировали информационные страницы и FAQ.
В выборке Алисы: 79 появлений приходились на статьи, 6 — на FAQ, 6 — на курсы и категории, 2 — на страницы специальностей.
То есть около 91% AI-видимости в этой выборке создавали статьи и FAQ.
Даже после многих лет работы внутренние 301, 404 и шаблонные ошибки продолжали появляться
В одном из последних массивов проблемных внутренних ссылок было 713 строк, 449 уникальных целевых URL и 145 страниц-источников.
Отдельно обнаруживалась шаблонная ошибка с буквальным фрагментом SITE_TEMPLATE_PATH внутри URL.
Это хороший пример того, что на большом проекте часть SEO-ошибок возникает не из стратегии, а из конкретного бага шаблона.
Что делать с таким техническим долгом
- заменить внутренние ссылки через 301 на прямые финальные 200 URL;
- исправить или удалить ссылки на 404;
- убрать буквальные шаблонные плейсхолдеры из HTML;
- не отдавать редиректные URL в sitemap;
- перераспределять внутренний ссылочный вес в сторону коммерчески важных категорий и курсов.
Рост проекта нельзя честно объяснить «сильной ссылочной кампанией»
В одном из последних больших внешних массивов было 1 347 строк, 234 уникальных домена-источника и 138 целевых URL.
Но распределение было далеко не идеальным.
Около 82,2% строк — 1 107 из 1 347 — вели на файлы в каталоге загрузок, а не на коммерческие страницы.
На курсы приходилось около 5,9%, на статьи — около 5%, на главную — около 3,3%.
В 2026 году аудит пришлось расширить до форм, аналитики и контура 152-ФЗ
Крупный образовательный сайт активно собирает персональные данные: заявки, обратные звонки, формы, подписки и другие обращения.
Поэтому техническое качество проекта нельзя оценивать только по robots.txt и canonical.
В отдельном аудите были выявлены:
Были подготовлены рекомендации по политике, отдельным согласиям, checkbox, cookie-баннеру, разделению согласия на обработку данных и рекламные рассылки, а также по запуску аналитических систем с учётом пользовательского согласия.
Повторяющиеся задачи большого сайта постепенно превратились в SEO Semantic Lab
На протяжении нескольких лет я снова и снова выполнял одинаковую тяжёлую последовательность:
- собрать запросы;
- проверить SERP;
- найти лидирующие URL;
- понять пересечение;
- кластеризовать;
- выбрать тип страницы;
- сравнить тексты;
- найти недостающие сущности;
- проверить внутреннюю конкуренцию;
- подготовить ТЗ.
Часть этих операций сначала делалась таблицами и отдельными скриптами, затем стала автоматизироваться в собственном программном продукте.

Десктопный инструмент для работы с семантикой, SERP-кластеризацией, конкурентами, текстовым анализом, ссылками и подготовкой стратегии.
На подобных больших проектах он полезен именно тем, что связывает несколько видов анализа в одном рабочем контуре.
Подробнее о SEO Semantic LabВ 2026 году на отдельных страницах подход стал ещё более точечным: вместо требования «дописать ещё 5 000 знаков» я сравнивал страницу с конкурентами, смотрел ContentEffort и усиливал конкретные зоны: Title, первый экран, H2, коммерческие сущности, FAQ, программу, стоимость, формат, квалификацию и schema.
Проблема роботного и ПФ-трафика со временем выросла в самостоятельное направление — AntiPF
Проект годами показывал одну и ту же практическую проблему: если автоматизированный трафик смешивается с реальными пользователями, аналитика начинает давать ложные сигналы.
Можно ошибочно считать страницу сильной или слабой, неправильно оценивать конверсию и принимать решения по загрязнённым данным.
Антибот-эксперимент 2023 года был одной из ранних практических точек, где я системно измерял роботность, нагрузку и качество трафика.
Позже задача выросла в отдельный продукт.
AntiPF развивает идею защиты аналитики и сайта от нежелательной автоматизированной активности: локальные события, поведенческие сигналы, поисковые роботы, сетевые признаки, антифрод-аналитика и связка с рекламными источниками.
Подробнее об AntiPFЧто не получилось или получилось хуже, чем хотелось
Часть структуры команда сделала по собственной логике. Это создало долг, который потом пришлось исправлять значительно дороже, чем если бы семантическая архитектура была утверждена до разработки.
На длинном проекте смена разработчиков означала разный уровень понимания SEO. Иногда исправление одного бага создавало другой. Поэтому контроль production стал обязательной частью работы.
Несмотря на улучшение части индексации и рост отдельных новых страниц, домен в целом просел в Google. Этот результат нельзя прятать за сильным Яндексом.
В 2025 году трафик мог расти одновременно со снижением заявок. Это заставило полностью изменить способ оценки SEO и отделить информационный охват от коммерческой эффективности.
Информационная безопасность, автотранспорт / БДД и наставничество в широких годовых сравнениях показывали отрицательную динамику.
Значит, общесайтовый рост нельзя механически переносить на каждое направление.
404, редиректы, noindex, шаблонные ошибки и внутренние ссылки — это не задачи, которые можно закрыть навсегда на активно меняющемся сайте.
Что я бы сделал иначе, если бы новый сайт проектировался сегодня
1. Семантическая архитектура до дизайна
Сначала кластеры, типы страниц, URL и связи между ними. Только после этого — меню, шаблоны и визуальная структура каталога.
2. Полная карта старый URL → новый URL перед миграцией
Не просто «поставить редиректы», а определить судьбу каждого значимого исторического документа: перенос, объединение, 301, 410 или сохранение.
3. SEO acceptance checklist до production
Canonical, robots, noindex, sitemap, schema, pagination, фильтры, Open Graph, формы, редиректы и внутренние ссылки должны приниматься так же, как функциональность корзины или формы заявки.
4. Автоматический crawler diff после релиза
Сравнение до/после по статусам, метатегам, canonical, robots и шаблонным блокам позволило бы ловить ошибки в первые часы, а не после изменения индекса.
5. Тематические хабы вместо хаотичного роста статей
Каждая информационная тема должна иметь понятный коммерческий маршрут и не создавать каннибализацию с курсами.
6. SEO + CRM с первого дня
Источник → запрос → посадочная → заявка → оплата → обучение → документ.
Тогда бизнес-ценность каждого кластера можно оценивать не через общий трафик, а через фактическую отдачу.
Как менялся проект и мой подход к SEO
Оптимизация старой версии сайта
Existing HTML / legacy-сайт: структура, категории, метатеги, тексты, перелинковка, индексация и поиск первых точек роста.
Участие в создании новой версии
SEO-рекомендации к будущему сайту. Часть идей реализована, часть архитектуры команда сформировала без полного учёта SEO. После запуска начинается накопление и исправление технического долга.
Большой технический аудит
Скорость, 589 цепочек редиректов, 40 тыс.+ параметрических URL, индексирование, изображения, внутренние ссылки и страницы с показами без кликов. Повторная проверка подтверждает сильное улучшение серверного ответа.
Семантика, конкуренты, кластеризация
Распределение кластеров по типам страниц, анализ лидеров TOP, текстовая релевантность, внутренняя перелинковка и развитие отдельных направлений.
Масштабирование страниц профессий и ранний ChatGPT
Большие SEO-ТЗ, генерация отдельных блоков по подготовленным данным, ручная редактура и контроль интента.
Большие SERP-срезы и новое ядро
Повторные выгрузки запросов, лидеров и конкурентов. К концу года — новое ядро 51 328 фраз и большой исторический анализ Google.
Антибот-эксперимент
43,5 тыс. отфильтрованных обращений, заметное снижение серверной нагрузки, анализ расхождений Метрики, GSC и поисковых кликов.
Мониторинг и техническая стабилизация
GSC, 403 / 5xx, sitemap, индексирование, повторные технические проверки.
Noindex, SEO-плагины и переход к тематическим связкам
Контроль критичных технических настроек, усиление коммерческих страниц, статьи → тематические хабы → категории → курсы.
Точечный ContentEffort и бизнес-аналитика
Не наращивать текст ради объёма, а усиливать конкретные сущности и зоны страницы. Анализ трафика, заявок, документов, сезонности и коммерческой доли поиска.
Новые коммерческие хабы и AI/LLM-инфраструктура
Категории, внутренние связки, новые коммерческие посадочные, llms.txt, AI-policy, AI-sitemap и технический слой для генеративного поиска.
Новая кластеризация, аудит 152-ФЗ и итоговый срез
Большие конкурентные и семантические выгрузки, технический compliance, анализ Яндекса, Google, AI Search, Алисы, ссылок и индексации.
Deep Dive: дополнительные цифры и наблюдения, которые не нужны для первого экрана, но важны для методологии
Региональная поисковая видимость в 2023 году
В одном из крупных Google-срезов по выборке 3 000 запросов: 1 459 находились в TOP-10, 387 — в TOP-3, 145 — на первой позиции.
В Яндексе региональные выборки выглядели заметно слабее: Санкт-Петербург — 433 из 3 000 в TOP-10; Москва — 197 из 1 719; общероссийская выборка — 139 из 1 101.
Для меня это был важный сигнал: одну общую «видимость сайта» нельзя использовать без привязки к поисковой системе, региону и набору запросов.
243 страницы Google с показами, но без кликов в аудите 2022 года
Эти страницы суммарно имели около 90,5 тыс. показов.
Это классический резерв, где уже не нужно сначала «попасть в индекс»: поисковик знает документ и показывает его, но пользователь не кликает или позиция и сниппет недостаточно сильны.
Работа с таким массивом включает не только CTR: интент, соответствие страницы запросу, Title, Description, фрагмент выдачи, коммерческие сущности и саму позицию.
Почему 11 275 missing alt — не равно 11 275 уникальным проблемным изображениям
Значительная часть ошибок была вызвана повторяющимися шаблонными изображениями.
В анализе речь шла примерно о 315 уникальных изображениях, встречавшихся примерно на 321 странице.
Это пример, почему в техническом аудите нельзя ранжировать задачи только по числу строк: одна шаблонная ошибка может породить тысячи повторов.
Почему общий трафик +11,5% не используется как главный KPI
В одном общем годовом сравнении визиты выросли примерно с 141 446 до 157 773 — около +11,5%.
Посетители: 109 389 → 136 503, около +24,8%.
Просмотры: 218 680 → 236 664, около +8,2%.
Но одновременно количество визитов, классифицированных как роботные, выросло примерно с 10 348 до 36 435.
Поэтому общий график сайта сильно искажён и не годится как главный аргумент результата.
Почему крупнейший информационный кластер вынесен отдельно
Крупнейший информационный кластер вырос примерно с 45 до 5 685 визитов и формировал около пятой части текущих известных поисковых визитов Яндекса.
Чтобы не приписывать весь рост стратегии в целом одной странице, я пересчитал динамику без этого кластера.
Остальные известные запросы всё равно выросли примерно на 63,8%.
AI-видимость: почему нельзя писать «llms.txt дал 89 936 показов»
Внедрение AI/LLM-файлов и появление заметных Google AI-показов происходят в одном временном окне, но это не доказывает причинность.
На результат могли влиять уже существующий информационный контент, schema, авторитет страниц, ссылки, внутренние связи и изменения самого Google.
Поэтому корректная формулировка: «после внедрения сайт получил или имел заметную AI-видимость», а не «llms.txt обеспечил её».
Почему достижения целей Метрики нельзя назвать лидами
Одна сессия может активировать несколько целей.
Часть целей — микроконверсии: клик, шаг формы, просмотр контактов.
Поэтому 5 407 достижений целей Яндекса не означают 5 407 заявок.
Для бизнеса нужна отдельная CRM-цепочка и дедупликация.
Почему ухудшение поведенческих метрик нельзя игнорировать
В общем годовом сравнении показатель отказов ухудшался примерно с 26,13% до 31,43%.
Глубина: примерно 1,546 → 1,500.
Среднее время: примерно 1:39 → 1:23.
Часть искажения могла быть связана с роботным трафиком, но само наличие таких изменений — ещё одна причина не ограничиваться отчётом по посещаемости.
Когда такой формат работы особенно полезен
Этот подход подходит не только образовательным сайтам.
Он нужен там, где проект большой, исторический и постоянно меняется: сотни или тысячи URL, несколько разработчиков, сложная структура, контентная команда и непонятная связь между SEO-трафиком и реальным бизнесом.
- органический трафик падает, а причина не очевидна;
- Яндекс и Google ведут себя по-разному;
- есть много статей, но мало коммерческих переходов;
- новые страницы создаются без единой семантической архитектуры;
- после разработчиков постоянно возвращаются технические ошибки;
- есть подозрение на роботов или накрутку ПФ;
- нужно понять, какие категории и страницы создавать следующими;
- нужно второе мнение по работе текущего SEO-подрядчика.
Диагностика технических, структурных, семантических и коммерческих проблем сайта.
SEO-аудит сайтаИндексация, краулинг, canonical, redirects, robots, sitemap, шаблоны, статус-коды и контроль внедрений.
Технический аудитНезависимый разбор текущей стратегии, подрядчика, отчётов и реальных точек роста.
Обсудить задачуГлавный результат семи лет — не один график, а построенная система принятия SEO-решений
Проект прошёл путь от старого сайта, который приходилось оптимизировать в рамках исторических ограничений, до сложной современной платформы с коммерческими категориями, большим информационным слоем, собственными SEO-инструментами и присутствием в генеративном поиске.
Самая сложная часть этой истории — не собрать семантику и не написать несколько хороших текстов.
Сложнее годами удерживать в рабочем состоянии связь между поисковым спросом, архитектурой, разработкой, контентом, аналитикой и бизнесом , когда сайт постоянно меняется и разные участники команды принимают решения независимо друг от друга.
Именно поэтому этот проект важен для меня не только как клиентский кейс.
На нём годами обкатывались подходы, которые потом превратились в SEO Semantic Lab, повлияли на развитие AntiPF и сформировали мой сегодняшний способ работы с большими сайтами.
Домен и бренд проекта в публичной версии намеренно не раскрываются. Часть исторических документов 2019–2021 не сохранилась после ликвидации старого корпоративного почтового домена. Цифры 2022–2026 приведены по сохранившимся аудитам, Яндекс.Метрике, Яндекс.Вебмастеру, Google Search Console и внутренним аналитическим выгрузкам. Корреляции не трактуются как доказательство причинности; достижения целей не приравниваются к продажам; AI-показы не приравниваются к лидам.