Soltyk25 измеряет контекст вокруг ваших ключей на страницах конкурентов: какие слова и словосочетания чаще всего окружают запросы на близкой дистанции.
- Рассматривается окно ±N слов вокруг каждого вхождения ключевого слова. По умолчанию N = 25.
- Вклад соседей затухает с расстоянием по степенному закону: чем ближе к ключу — тем весомее.
- Плюс учитываются веса зон страницы (title, h1, p, ссылки, alt и т. д.): важные зоны дают больший вклад.
- На выходе вы получаете список терминов-подсказок: что имеет смысл упомянуть в тексте и в каких зонах это обычно встречается у сильных конкурентов.
Зачем это нужно? Чтобы не просто «вставить ключ», а вписать его в ожидаемую обвязку — так, как это делают лучшие документы в выдаче.
Где это видно в программе (интерфейс)
Всё, что связано с Soltyk25, пользователь видит в таблице «Стратегия» и в правой панели отчёта по кластеру:
- Колонка «Soltyk25» — краткое превью топ‑терминов (обычно топ‑20/топ‑120 под капотом). Это быстрый «слепок» контекста ниши.
- Блок колонок «Вектор …» по зонам: title, h1…h6, meta description, og:title, og:description, p, li, a, table, div, span, alt, nav. Это уже обычные частотные векторы по зонам — используются для ТЗ/заголовков.
- В отчёте по кластеру — секция «Soltyk25: сравнение с кластером»:
- «Отсутствуют у нас» — термины из кластера, которых нет на вашей странице.
- «Слабее, чем у кластера» — у вас есть, но вес < 50% от среднего конкурентного.
- Рядом — «Рекомендации для копирайтера»: что «вписать и куда» (по зонам).
- При экспорте в Excel выгружается и колонка Soltyk25, и все «Вектор …»-колонки (учтите лимит Excel ~32 767 символов на ячейку).
В SEO-отчете "Soltyk25 — релевантный URL":
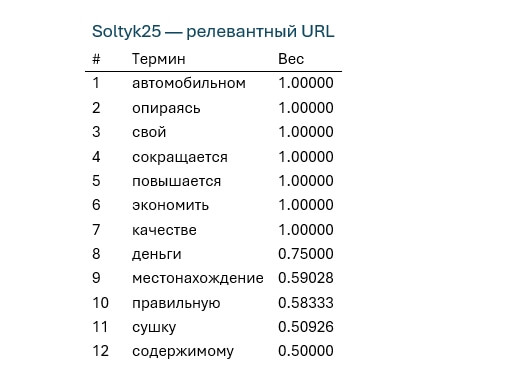
Быстрый старт: что делать пользователю
- Сформируйте кластер запросов и получите URL‑лидер (или выберите свою страницу для сравнения).
- Откройте «Стратегию» и посмотрите колонку «Soltyk25».
- В отчёте по кластеру изучите:
- «Отсутствуют у нас» — начните с верхних позиций.
- «Слабее, чем у кластера» — усилите эти термины в тексте.
- Загляните в «Рекомендации для копирайтера», уделите внимание зонам title/h1/p….
- При необходимости экспортируйте в Excel и передайте ТЗ редактору.
Из чего строится профиль Soltyk25 (данные)
- Запросы кластера → токенизируются/лемматизируются (для RU при наличии лемматизатора). Для каждого токена запроса считается «важность» (лог‑частота кластера).
- Страницы конкурентов → тексты собираются по зонам (title/h1/h2/h3/p/li/a/alt/nav/…), и на вклад соседей накладываются веса этих зон (по умолчанию: title=2, h1=2, h2=1.5, h3=1.25, p=1, li=1, a=0.8, alt=0.8, nav=0.6).
- Если зональные тексты недоступны, используется «литеральный» режим — расчёт по очищенному body‑тексту.
Алгоритм «на пальцах»
- Берём каждое вхождение любого токена запроса на странице конкурента.
- Смотрим окно ±N вокруг этого вхождения.
- Каждому соседнему токену t начисляем вклад:
- ближе к ключу → больше вес,
- важнее зона → больше вес,
- чаще ключ встречается в кластере → больше вес.
- Складываем вклады по всем окнам и всем страницам конкурентов.
- Формируем средний кластерный профиль по каждому термину (усреднение по документам, где термин присутствует).
- В витрину для пользователя (списки топ‑терминов) обычно не попадают сами слова запроса — чтобы фокус остался на их «обвязке».
Строгая часть: формулы
Ниже — компактные формулы. Их задача — зафиксировать логику, а не усложнить использование.
Важность токена запроса в кластере
tf(q) = log(1 + count_cluster(q))
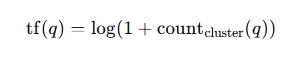
Веса зон (по умолчанию)
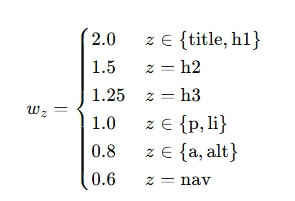
Вклад соседа из окна ±N
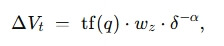
ΔV_t = tf(q) · w_z · δ^(-α), где δ — расстояние в токенах (1…N) от q до t. Суммируется по всем окнам/позициям.
Литеральный режим (fallback)
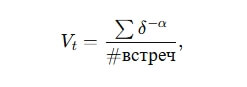
V_t = ( Σ δ^(-α) ) / (# встреч), после расчёта (если включено) исключаем сами запросные токены из витрины.
Средний кластерный профиль
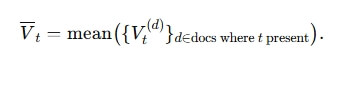
\bar{V}_t = mean( { V_t^(d) } по документам d, где t встречается )
Настройки по умолчанию (что они значат)
- Окно N = 25 — глубина контекста вокруг ключа. Больше N → шире контекст, но сильнее «размывание».
- Затухание α = 1.0 — как быстро падает важность с расстоянием.
- Топ‑K = 120 — сколько терминов выводить в витрине.
- Исключать запросные токены — включено: фокус на контекст, а не на повторение ключей. Все значения хранятся в настройках программы и предустановлены «из коробки».
Как читать результаты и что делать с ними
- «Soltyk25 (кластер)» — эталонный контекст ниши: какие слова окружают ключи у лучших.
- «Отсутствуют у нас» — список к внедрению в первую очередь (двигайтесь сверху вниз).
- «Слабее, чем у кластера» — укрепляйте эти термины в тексте, но естественно.
- «Рекомендации для копирайтера» — подсказывают куда именно: title/h1/p/li…
- «Топ‑6 соседей» для каждого ключа (3 слева + 3 справа) помогает писать естественные «обвязки» вокруг запросов.
Экспорт в Excel и практические примечания
- В Excel выгружаются и Soltyk25, и все «Вектор …»‑колонки.
- Помните про предел длины ячейки (~32 767 символов) и локальные настройки чисел (десятичный разделитель в русской локали — запятая).
Сравнение Soltyk25 с другими методами
Ниже — чем Soltyk25 отличается от популярных подходов, и как их комбинировать.
Косинусная близость (TF‑IDF/BoW/Bag-of-Words)
Что делает. Сравнивает два вектора (например, TF-IDF) как
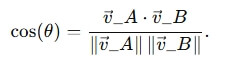
Плюсы
- Простая, быстрая, стабильная метрика «похожести» документов.
-
Хороша для грубого “насколько в целом похожи” кластер ↔ ваша страница.
Минусы
- Не чувствует расстояний между словами и порядок (мешок слов).
- Обычно не знает про зоны (title/h1 и т. д.) без ручного усложнения.
- Возвращает число, не говорит, что именно вставить.
Итог в связке
- Используйте косинус как «общий термометр похожести», а Soltyk25 — как рецепт конкретных дополнений.
BM25 (классический поисковый скорер)
Что делает. Суммирует вклад терминов с IDF и насыщением частот:
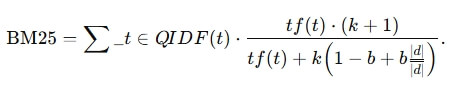
Плюсы
- Устойчив к переспаму (насыщение), учитывает длину документа.
- Отлично подходит для ранжирующих/ретривинговых задач.
Минусы
- Нет близости по расстоянию и нет зональных весов из коробки.
- Не даёт списков контекстных соседей «что дописать».
Итог в связке
- BM25 — для подбора релевантного корпуса/эталонов, Soltyk25 — для контентных рекомендаций по этому корпусу.
Эмбеддинги (word2vec/FastText/SBERT)
Что дают: семантическую близость/синонимы.
- Плюсы: находят перефразы и латентные связи.
- Минусы: слабая объяснимость для редактора; без окон не учитывают локальную близость; зависят от модели.
- Как сочетать: эмбеддинги — для синонимов; Soltyk25 — чтобы «приземлить» их рядом с ключом и по правильным зонам.
PMI / NPMI (ассоциации по совместной встречаемости)
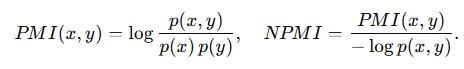
Плюсы
- Явно измеряет «насколько часто встречаются вместе».
- Полезно для научных/нишевых терминов и устойчивых словосочетаний.
Минусы
- Требует большого и чистого корпуса; чувствителен к шуму/скрейпу.
- Не учитывает расстояние и зоны без надстроек.
Итог в связке
- PMI/NPMI — для проверки сильных коллокаций,
- Soltyk25 — чтобы понять на каких дистанциях и в каких зонах это реально используется на топ-страницах.
RAKE/YAKE, TextRank/KeyBERT (keyphrase‑extract, ключевые слова из текста)
Плюсы
- Быстро дают кандидаты ключевых фраз.
- Хороши как стартовый список для брифа.
Минусы
- Ориентированы на внутреннюю структуру одного текста, а не на окружение ключей в нише.
- Зоны и расстояния обычно не учитываются.
Итог в связке
- Эти методы — чтобы набросать семантику, Soltyk25 — чтобы выверить контекст на основе лучших конкурентов.
Тематические модели (LDA и др.)
Плюсы
- Показывают темы/подтемы корпуса — стратегический обзор.
Минусы
- Темы размыты, не скажут «вписать это рядом с ключом».
- Настройка, интерпретация и стабильность зависят от корпуса.
Итог в связке
- LDA — для карты тем,
- Soltyk25 — для пошаговых правок текста под запрос.
Трансформеры-кросс-энкодеры (BERT-классификаторы релевантности)
Плюсы
- Максимальная точность в оценке релевантности пары «запрос—документ/пассаж».
Минусы
- Тяжёлые вычислительно, требуют датасетов и MLOps.
- Возвращают оценку, а не список конкретных слов/зон.
Итог в связке
- Нишево: как «вердикт-оценщик»,
- Soltyk25 — как редакционный план действий.
Сводная таблица выбора
| Задача | Лучше подойдёт | Роль Soltyk25 |
|---|---|---|
| Проверить общую похожесть | Косинус, BM25 | Дать конкретные правки |
| Найти синонимы/перефразы | Эмбеддинги | Привязать их к окну и зонам |
| Проверить устойчивые связки | PMI/NPMI | Показать дистанции/зоны использования |
| Спроектировать разделы | LDA/тем. модели | Конвертировать темы в правки текста |
| Финальная оценка | Кросс‑энкодеры | Сформировать редакционный план |
Плюсы Soltyk25 в лоб: локальная близость + зональность + объяснимость + скорость.
Минусы: не «понимает смысл» как нейросети; требовательность к чистоте парсинга/токенизации; параметры N, α, веса зон — важны дефолты (в программе преднастроены).
Рекомендуемая практическая связка (pipeline)
- Подбор эталонов: BM25/косинус → отбираем сильный пул конкурентов.
- (Опционально) Карта тем: LDA → разделы/подтемы.
- Черновой набор фраз: RAKE/YAKE/KeyBERT.
- Контекстная подгонка: Soltyk25 → «что добавить и в какие зоны».
- Синонимизация: эмбеддинги → естественные формулировки.
- Контроль качества: косинус/встроенные метрики видимости → проверка без переспама.
Чек‑лист копирайтера (коротко, по делу)
- Не гонитесь за количеством — берите верхние строки списков.
- Сначала закройте «Отсутствуют у нас».
- Усиливайте «Слабее, чем у кластера», но избегайте тавтологии.
- Разносите термины по зонам: заголовки — про основные «смысловые оси», p/li — про детализацию.
- Пишите естественно: соседние слова вставляйте как «обвязку», а не как набор меток.
- Проверяйте читабельность и структуру (подзаголовки, списки, таблицы).
- Следите за релевантностью иллюстраций/alt — это тоже зона.
- Не переспамливайте a‑якоря: смысл > частотность.
- После правок — ещё раз сравните с кластером (свести «красное» к нулю).
- Зафиксируйте результат в Excel/ТЗ и передайте в прод.
Частые вопросы (FAQ)
Это не превратится в переспам?
Нет, если соблюдать приоритеты и писать естественно. Soltyk25 подсказывает контекст, а не «сколько раз повторить ключ».
Почему мои ключи не видны в списке?
Обычно они исключаются из витрины, чтобы акцент был на соседях/обвязке.
Как часто пересчитывать?
При значимых изменениях у конкурентов или после релизов ваших правок.
Что если страница «картинка и чуть текста»?
Уделите внимание alt, подписям, title/h1, кратким «объясняющим» абзацам и близким к ним терминам.
Мини‑глоссарий
- Окно (±N): диапазон вокруг ключа, где ищутся соседи.
- Зоны: части страницы с разной «силой»: title/h1/h2…/p/li/a/alt/nav.
- Витрина: читаемый для пользователя список топ‑терминов.
- Кластер: набор запросов и соответствующих URL/конкурентов.
- Mean over present: усреднение по документам, где термин встречается (без нулей).
Итог
Soltyk25 — это практический мост между анализом выдачи и редактурой: он превращает «сильные» соседства ключей у конкурентов в конкретные, зонально‑привязанные рекомендации, которые можно сразу нести в текст, заголовки и метаданные. На простой стороне — понятные подсказки; на строгой — внятные формулы и контроль параметров. Всё это работает из одной страницы интерфейса и логично дополняет любые ваши метрики похожести и видимости.
